KIHier ist eine KI-generierte Zusammenfassung meines Artikels.
Von mir geprüft: Ich habe diese Zusammenfassung mit dem Artikel abgeglichen.
Der Bias liegt in den Daten – aber es gibt einen Weg
TL;DR (für die, die es eilig haben)
Hier ist der Denkfehler, den fast alle machen: Du denkst, bessere Architektur löst schlechte Daten. Spoiler Alert: Tut sie nicht.
Die Realität: Bias sitzt in den Daten und gelernten Darstellungen der Welt. Modell-Architektur kann es nicht eliminieren, aber sie kann schnellere Erkennung und Korrektur ermöglichen.
Der Plan: Dezentralisierte Architekturen (MoE, sparse, modular) + kontinuierliches Lernen + rigorose Daten-Kuratierung + RLHF = ein System, das nicht nur toleriert Bias, sondern sich davon wegadaptiert.
Das ist nicht „dezentralisierte KI löst Bias." Es ist „dezentralisierte KI + intelligentes Post-Training + Daten-Qualität = marginal weniger brüchige Bias-Mitigation als heute's gefrorene, prompt-gepatschte Modelle."
Modelle sind Biased
Ich habe letzten ein Bild von mehreren verschiedenen KIs generieren lassen: ein CEO mit seinem Board bei einem Meeting. Rate mal: welches Geschlecht und welche Hautfarbe hatten die CEOs? Richtig! Fast alle waren männlich, weiß und eher höheres Alter. Probiere es gerne selbst aus mit deinen eigenen Prompts!
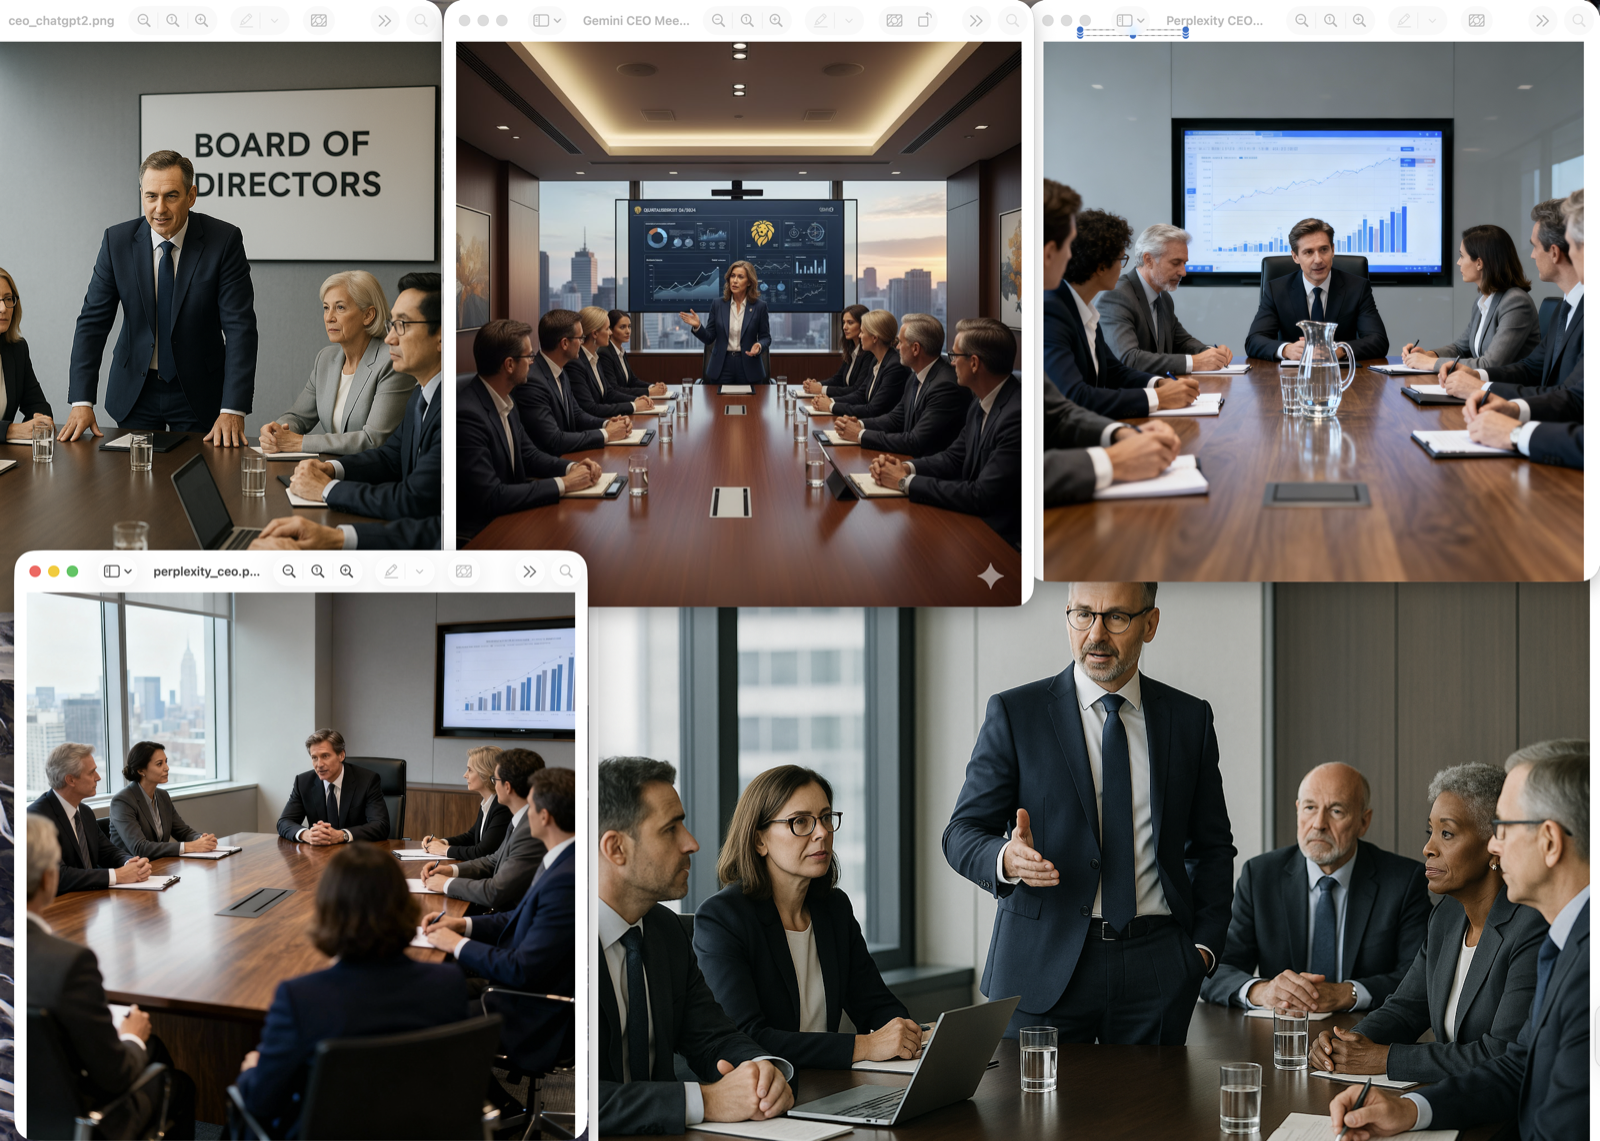
Und du kennst das bestimmt auch: Wenn KI-Modelle voreingenommen sind, zeigen alle auf das Modell. Aber hier ist das Problem: Aber das ist, als würde man einen Spiegel dafür beschuldigen, dass er zeigt, was im Zimmer ist.
Große Sprachmodelle wie GPT oder Claude trainieren auf Hunderten von Milliarden Text-Tokens aus Wikipedia, Reddit und Büchern. Sie erfinden keine Vorurteile und Stereotype. Sie absorbieren sie aus den Daten.
Frauen werden in den Trainingsdaten häufiger als „schlank" und „schön" beschrieben als Männer – und auch genauso generiert. CEOs werden in Texten zu ~80% mit männlichen Pronomen benannt. Das Modell lernt diese statistischen Regelmäßigkeiten. Nach dem Training friert das Modell ein. Diese gelernten Assoziationen bleiben eingefroren.
Und jetzt fragst du dich wahrscheinlich: Wie zum Teufel löst man das?
Das ist kein Architektur-Problem. Das ist ein Daten-Problem.
Ein Lösungsansatz
Brunet et al. (2019) zeigten das empirisch in ihrer Studie „Understanding the Origins of Bias in Word Embeddings": Bias sitzt im semantischen Raum – der mathematischen Struktur von Bedeutung. Noch wichtiger: Sie haben eine Methode entwickelt, um spezifische Trainingsdokumente zu identifizieren, die Bias am stärksten verursachen. Mit Influence Functions analysierten sie Wikipedia und New York Times-Daten und zeigten präzise, welche Artikel überproportional zu Geschlechter-Stereotypen in Word Embeddings beitragen. Besonders auffällig: Seltene Wörter waren extrem sensibel für diese Verzerrungen.
Die Gleichung ist einfach: Biased Trainingsdaten → Biased gelernte Repräsentationen → Biased Outputs. Ändere die Architektur, behalte die biased Daten, und der Bias bleibt. Das funktioniert nicht mal auf der Ebene des Modells, sondern schon auf der Ebene der Tokens.
System Prompts behandeln nur die Symptome
Wenn du ChatGPT sagst: „Generiere diverse CEO-Profile mit ausgeglichenem Geschlechtsanteil“, siehst du live, wie Konzerne diesem eingebauten Bias entgegensteuern. Sie machen dasselbe schon vorher: Sie sagen der KI unsichtbar, dass die Geschlechter ausgeglichen sein sollen – noch bevor du das Chat-Fenster öffnest.
Der eigentliche Hebel liegt aber im Alignment. Nach dem Pretraining wird das Modell so nachjustiert, dass es den Wünschen der Entwickler folgt: Antworten, die man vermeiden will (eine Bombenbau-Anleitung oder nur männliche, weiße CEOs), werden abgestraft. Antworten, die in die gewünschte Richtung gehen, werden belohnt. Damit liegt die Macht über die Normen, die das Modell verkörpert, bei einigen wenigen großen Anbietern.
System Prompts sind dagegen nur ein Pflaster. Sie geben dem Modell zusätzliche Regeln, aber der tieferliegende Bias in den Daten bleibt. Ein System Prompt kann vorschreiben: „Wechsle die CEO-Geschlechter ab“, doch im Inneren assoziiert das Modell „CEO“ nach wie vor stärker mit männlichen Mustern.
Genau deshalb fühlt es sich fragil an – weil es fragil ist.
Hier ist eine Liste der Maßnahmen, die AI-Engineers anwenden können. Die Frage ist: Welche funktionieren wirklich?
Die Hierarchie der Bias-Interventionen
| Methode | Wann | Tiefe | Was |
|---|---|---|---|
| System Prompts | nach Training | Oberflächlich | Instruktions-Override; ändert keine Gewichte |
| Fine-tuning / LoRA | Nach Training | Flach | Trainierbare Adapter auf gefrorenem Basis-Modell |
| RLHF (Reinforcement Learning from Human Feedback) | Nach Training | Tief | Menschen labeln Bias-Beispiele; Reward Model lernt; LLM optimiert gegen Reward (PPO) |
| Datenselektion | Vor Training | Tiefste | Bias-Daten umgewichten, filtern oder augmentieren |
RLHF ist, wo echte Veränderungen stattfinden. Menschen labeln Tausende Beispiele: „Ist diese Antwort biased?" Ein separates Reward Model lernt, Bias zu erkennen. Das LLM wird dann via Reinforcement Learning optimiert, um das „non-biased"-Reward-Signal zu maximieren. Das ändert die internen Gewichte.
Studien zeigen, dass RLHF messbaren Bias stärker reduziert als Instruction-Tuning allein. Aber es kämpft immer noch upstream – das Basis-Modell wurde mit biased Daten trainiert. RLHF versucht, eine korrigierte Schicht hinzuzufügen, nicht das Fundament neu zu schreiben.
Die ideale Lösung ist upstream: Datenseketion. Aber das ist teuer, langsam und unvollständig (Bias ist kontextabhängig; was in einem Kontext biased ist, ist in einem anderen neutral).
Praktisch: Brunet et al. und gezieltes Data-Pruning
Hier ist etwas, das oft übersehen wird: Brunet et al. (2019) zeigten, dass man Bias-verursachende Trainingsdokumente mit hoher Präzision identifizieren kann – ohne das Modell jedes Mal neu zu trainieren.
Mit Influence Functions konnten sie berechnen: „Diese 500 Wikipedia-Artikel verursachen 40% des Bias-Signals." Und das kann man vor dem LLM-Training tun.
Das hat zwei Implikationen:
- Für heutige LLMs: Data-Auditing und gezieltes Entfernen von Bias-Quellen könnte die Basis reduzieren, bevor RLHF überhaupt anfängt.
- Für dezentrale Systeme: Wenn du Module oder Experts hast, könntest du diese Analyse auf Modul-Ebene durchführen – „Welche Daten hat Expert #3 gelehrt, Gender zu stereotypisieren?" – und dann lokal interveniern.
Das ist nicht revolutionär, aber es ist umsetzbar und führt zu tiefgreifenden Veränderungen – im Gegensatz zu „System Prompts patchen und hoffen".
Wo moderne LLMs bereits sparse sind (und es hilft nicht beim Bias)
Bevor wir zu Lösungen kommen, lass uns mal über etwas sprechen, was die meisten übersehen: Große Sprachmodelle sind bereits, teilweise, dezentralisiert.
- Mixture of Experts (MoE): Mixtral 8x7B routet jeden Token zu nur 2 von 8 Expert-Sub-Netzwerken. Nicht alle Parameter feuern. Das ist Sparse Activation – wie bei Gehirn-Minicolumns.
- Multi-Head Attention: Claude hat 32 Attention Heads (von Modell zu Modell unterschiedlich). Jeder Head spezialisiert sich auf unterschiedliche linguistische oder semantische Muster. Das sind Mini-Experten, die konkurrieren und kooperieren.
- Sparcity ist intrinsisch: Frankle & Carbin (2019) zeigten, dass große, zufällig initialisierte Netzwerke kleine Subnetze ("winning tickets") enthalten, die – wenn mit ihrer ursprünglichen Initialization trainiert – die gleiche Genauigkeit erreichen wie das Vollnetzwerk. Das bedeutet: Sparcity sitzt bereits in der Struktur; Überparametrisierung hilft nur, die richtigen (sparsären) Sub-Netzwerke zu finden.
Aber hier ist die kritische Beobachtung: Mixtral zeigt so viel Bias wie dichte Modelle, die auf den gleichen Daten trainiert wurden.
Warum? Hier ist die brutale Wahrheit: Sparcity ist nur Architektur. Bias steckt in den Daten. Du kannst sparse Netzwerke machen; du kannst keine unbiased Repräsentationen machen, wenn die Daten von vornherein biased waren - unser Gehirn ist auch energieeffizient durch Sparcity und auch extrem biased. Dazu habe ich bereits etwas geschrieben: Was Neurowissenschaft der KI beibringen kann
Das ist eine entscheidende Erkenntnis: Dezentralisierung löst Daten-Bias nicht.
Warum Dezentralisierung trotzdem helfen könnte (Der Hybrid-Play)
Wenn Sparse-Architektur allein Bias nicht behebt, warum darüber diskutieren?
Weil Dezentralisierung etwas ermöglicht, das dichtere Systeme schwer schaffen: Modularität, Interpretierbarkeit und kontinuierliches Lernen.
Und hier ist meine These: Die Hybrid-Lösung könnte funktionieren – aber nicht aus den Gründen, die du vielleicht denkst.
1. Modulare Bias-Erkennung: In einem Mixture of Experts Setup könntest du jeden Expert separat überwachen. Wenn Expert #3 konsistent Gender-Stereotype generiert, isolierst und trainierst du nur dieses Modul neu – nicht das ganze 70B-Parameter-Modell.
Das ist nicht Theorie: Brunet et al. zeigten, dass man auf Dokument-Ebene Bias-Quellen identifizieren kann (Influence Functions). Auf der gleichen Logik könntest du auf Module-Ebene tracken, welcher Expert welchen Bias trägt – und dann gezielt intervenieren. Das ist viel präziser als globale RLHF.
2. Kontinuierliche Anpassung: Aktuelle LLMs frieren nach dem Training ein. Dein Gehirn nicht – es lernt kontinuierlich durch lokale Updates (synaptische Plastizität). Eine dezentralisierte Architektur könnte Online-Lernen ermöglichen: kleine Korrektionen in Reaktion auf User-Feedback oder neue Daten, ohne von Grund auf umzutrainieren.
3. Interpretability-Hebel: Dichte Modelle sind Black Boxes. Sparse, modulare Modelle haben klarere Entscheidungsgrenzen. Wenn du identifizieren kannst, welcher Expert biased Output produziert, kannst du ihn überprüfen und reparieren.
4. Daten-Qualitäts-Multiplikation: Kombiniere dezentralisierte Architektur mit besserer Datenselektion. Die Daten sind immer noch am wichtigsten – aber wenn dein System sich lokal an neue Daten anpassen kann, bekommst du eine Bias-Korrektur, die bisherige Modelle nicht haben.
Die Forschungs-Agenda
Das bleibt hypothetisch. Die empirische Frage ist nicht beantwortet:
- Zeigen Spiking Neural Networks (neuromorph, sparse, ereignisgesteuert) weniger Bias als dichte Transformers, wenn sie auf den gleichen Datensatz mit den gleichen RLHF trainiert werden? Denn wenn wir ein NN bauen, welches dem Gehirn ähnlicher ist, wird es das nicht zwingend besser machen - denn auch wir Menschen sind sehr biased - aber vielleicht kann es einen datengetriebenen Bias besser ausgleichen.
- Können Federated Learning Setups (verteiltes Training, lokale Updates) Bias schneller erkennen und korrigieren als zentralisiertes Training?
- Reduziert Online Learning (kontinuierlich, kleine Updates) schädliche Bias-Drift über die Zeit besser als regelmäßiges Umtrainieren des gesamten Modells?
Das sind alles testbare Hypothesen. Und rate mal? Niemand hat sie bisher richtig getestet.
Fazit: Die Reihenfolge der Operationen ist wichtig
Die großen KI-Modelle haben weiterhin dasselbe Problem wie unser Gehirn - die Date sind entscheidend. Genauso sind auch wir biased - wenn wir gestern einen James Bond gesehen haben, finden wir am nächsten Tag verrückte Gadgets, Aston Martins und Martini deutlich cooler als ohne den Film. Das ist ein Bias, den wir nicht abstellen können - und genau das Problem haben die KI-Modelle auch. Was wir machen können: wir können uns dem Bias bewusst sein und dann aktiv dagegensteuern - aber es geht nur, wenn wir wissen, dass wir biased sind. Wenn in deiner Familie bereits Klavier gespielt wurde, magst du Klavier deutlich lieber als andere Menschen - deine Wandfarbe als Kind war blau, dann magst du wahrscheinlich blau sehr gerne. Wir sind biased, weil es evolutionär Sinn ergibt, schnell Dinge einzuordnen - Freund oder Feind? - es führt nur dazu, dass wir aktiv dagegen steuern müssen und aktiv denken: "Die Hautfarbe, Geschlecht sind egal, CEOs müssen keine Männer sein". Es ist schwer, aber es geht. Und das zeigt, wie schwer es auch ist, ein Modell so zu trainieren, dass es nicht biased ist.
Aber was bedeutet biased denn überhaupt? Denn alles ist biased - es ist immer abhängig vom Kontext. Jeder hat eine andere Sichtweise. Deshalb - der Bias wird nie weggehen - aber wir können ihn hin zu einer Welt pushen, die für alle potenziell und hoffentlich am besten ist - eine Welt, in der niemand auf Grund seines Geschlechts oder seiner Hautfarbe geringere Chancen hat.
Bis dahin? Bauen wir immer noch nur bessere Spiegel. Und du weißt was? Die Reflexion wird erst besser, wenn das, was im Zimmer steht, sich ändert. Vielen Dank fürs Lesen 🙌
Quellen & Weiterführende Literatur
- Brunet, M. E., Alkalay-Houlihan, C., Anderson, A., & Zemel, R. (2019, May). Understanding the origins of bias in word embeddings. In International conference on machine learning (pp. 803-811). PMLR.
- Zeigt, wie man Bias-verursachende Trainingsdokumente mit Influence Functions identifiziert.
- Frankle, J., & Carbin, M. (2018). The lottery ticket hypothesis: Finding sparse, trainable neural networks. arXiv preprint arXiv:1803.03635.
- Zeigt, dass große, zufällig initialisierte Netzwerke kleine Subnetze enthalten, die bereits bei Initialization optimal strukturiert sind. Diese "winning tickets" erreichen volle Genauigkeit mit 10-20% der Parameter, wenn sie mit ihrer ursprünglichen Initialisierung trainiert werden. Beweis, dass Sparcity intrinsisch ist, nicht nachträglich hinzugefügt.
Hinweis: Einige Zahlen und Aussagen in diesem Artikel sind Annäherungen oder basieren auf Beobachtungen aus der Praxis. Für die genauen Zahlen rate ich dir, die zitierten Papiere direkt zu lesen.
Bis zum nächsten Mal, Euer Max